Cel mai bun are nevoie de un server. Cel care rulează chiar pe placa ta video e mai aproape decât crezi.
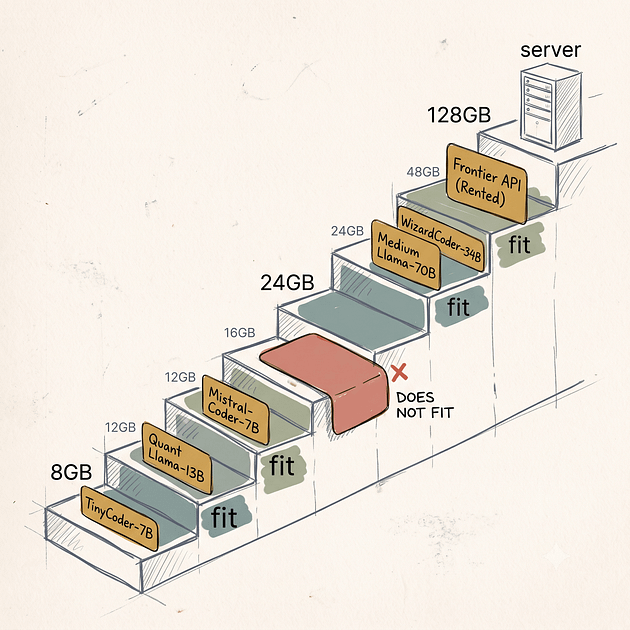
Modelele de programare open-source au ajuns din urmă modelele de top în 2026. DeepSeek V4 Pro a obținut recent un scor de 80,6% pe platforma de evaluare SWE-bench Verified, plasându-se la același nivel cu cele mai scumpe modele cu sursă închisă din lume.
Dar iată catch-ul. Cel mai bun model open-source de programare din momentul de față are nevoie de un rack de servere pe care nu îl deții. Cel care rulează pe o singură placă video de 24 GB este un cu totul alt model și se apropie de cele din top mult mai mult decât te-ai fi gandit. Întrebarea nu este care model e cel mai bun în general. Întrebarea este care model e cel mai bun pe care îl poți rula efectiv pentru tipul de cod pe care îl scrii.
Iată 10 opțiuni care merită știute. Una se va potrivi echipamentului tău, alta buzunarului tău.
Nivelul 1: Turneul Frontier Open Six
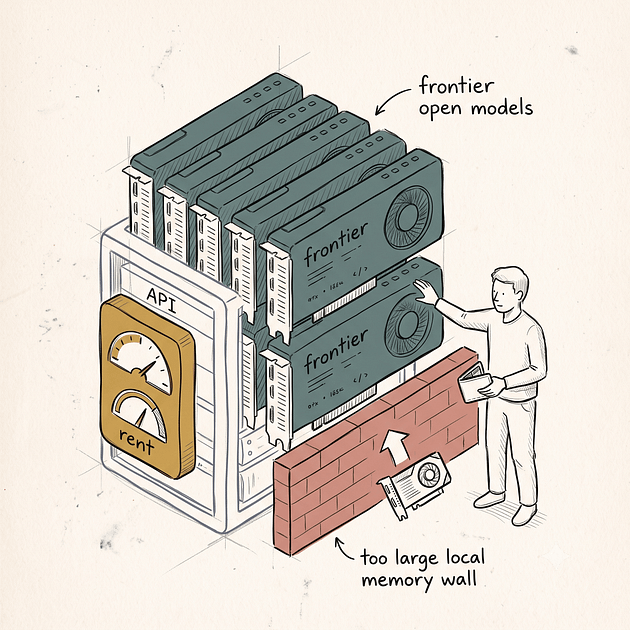
Acestea sunt modelele care concurează direct cu cele din ecosistemele închise. Ele au între 400 de miliarde și aproape trei mii de miliarde de parametri. Cel mai probabil, le veți accesa printr-un API, în loc să le rulați pe propriul hardware. Războiul prețurilor dintre laboratoarele de inteligență artificială înseamnă că acum le puteți închiria la o fracțiune din costul unui API proprietar. În această categorie, open-source înseamnă că obțineți un punct de acces API ieftin și ușor de înlocuit, fără riscul de a depinde exclusiv de un singur furnizor.
Zhipu a creat GLM-5.2 pentru sarcini complexe de inginerie în mai multe etape, care acoperă depozite de cod extinse. Modelul își menține concentrarea și urmărește dependențele dintre variabile de-a lungul întregii sale ferestre de context de 1 milion de tokeni.
GLM-5.2
Funcționează sub licență MIT și are în total aproximativ 753 de miliarde de parametri. Folosește o arhitectură de tip amestec de experți (MoE), ceea ce înseamnă că doar o fracțiune din parametri rulează pentru fiecare token, mai exact în jur de 40 de miliarde. Ocupă primul loc printre modelele open-source în dificilul test SWE-bench Pro, cu un scor raportat de 62,1%. Costurile API-ului se ridică la aproximativ 1,40 dolari pentru datele de intrare și 4,40 dolari pentru cele de ieșire per milion de tokeni.
Gestionarea unei ferestre de context de 1 milion de tokeni presupune anumite compromisuri de arhitectură. Pe măsură ce contextul se extinde, mecanismul de atenție se confruntă de obicei cu degradarea de tip „acul în carul cu fân”, caz în care detaliile ascunse prin mijlocul promptului ajung să fie ignorate. GLM-5.2 folosește o variantă modificată a tehnicii de scalare prin încorporare rotațională a poziției (RoPE), care își menține capacitatea de a regăsi informațiile din mijlocul contextului mult mai bine decât versiunile anterioare. Așa că, atunci când inserezi arborele sintactic abstract al unui întreg repository în prompt, modelul chiar se folosește de el.
Codul Kimi K2.7
Moonshot AI a creat Kimi K2.7 Code pentru a acționa autonom. Dacă îndrepți acest model spre o problemă de pe GitHub care descrie o eroare de concurență într-un proces al fundalului, el va scrie corectura, va rula suita de teste, va citi jurnalele de erori și va rescrie funcția până când toate testele sunt trecute. Foaia de prezentare a modelului indică faptul că arhitectura folosește sute de subagenți pentru a coordona mii de pași pe parcursul unei singure solicitări complexe.
Kimi K2.7 Code are în total aproximativ un trilion de parametri și activează 32 de miliarde per token, funcționând în baza unei licențe MIT modificate. Dacă dezvoltați un agent intern de programare care trebuie să interacționeze iterativ cu un compilator sau un linter, acest model oferă fiabilitatea necesară în utilizarea uneltelor.
Fiabilitatea în regim de agent provine din modul în care a fost antrenat ulterior modelul. În loc să beneficieze doar de reglarea fină standard pe bază de instrucțiuni, Kimi K2.7 a trecut printr-un proces amplu de învățare prin consolidare, folosind traiectorii bazate pe rezultate reușite și eșuate ale compilatorului. Modelul înțelege că o eroare de sintaxă nu înseamnă un eșec total, ci un semnal prin care își poate corecta pasul anterior.
DeepSeek V4 Pro și Flash
DeepSeek V4 face ca utilizarea API-ului să fie mai ieftină decât electricitatea consumată de propriul server. Poți procesa milioane de tokeni de jurnale, documentație și cod pe nimic, ceea ce o transformă în opțiunea ideală pentru generarea automată de documentație în masă și analiza fluxurilor CI/CD.
Atât varianta Pro, cât și cea Flash oferă o fereastră de context de un milion de tokeni sub licență MIT. V4 Pro costă aproximativ 0,435 dolari pentru input și 0,87 dolari pentru output la fiecare milion de tokeni, în timp ce pentru varianta V4 Flash costurile scad la 0,14 dolari, respectiv 0,28 dolari.
Pentru a integra acest lucru într-un flux de lucru automatizat, este nevoie de codul standard pentru SDK-ul OpenAI, în care trebuie doar să schimbi adresa URL de bază și ID-ul modelului.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com/v1"
)

# Using the ultra-cheap Flash variant for high-volume log analysis
response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {"role": "system", "content": "You are a strict code reviewer."},
        {"role": "user", "content": "Review this pull request for race conditions: ..."}
    ],
    max_tokens=2048
)

print(response.choices[0].message.content)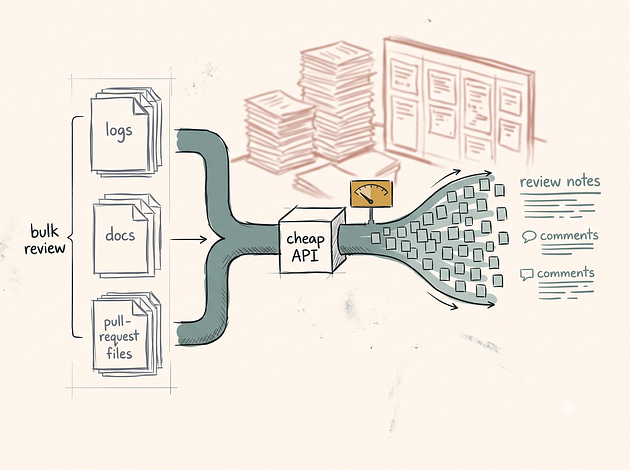
Qwen3-Coder-480B-A35B
Alibaba a lansat acest model „mixture-of-experts” de 480 de miliarde de parametri sub licență Apache 2.0. Modelul procesează 256.000 de tokeni și obține un scor declarat de 69,6% pe SWE-bench Verified.
Multe modele cu ponderi deschise folosesc licențe personalizate care restricționează utilizarea comercială sau impun raportarea veniturilor peste un anumit prag. Licența Apache 2.0 elimină aceste bătăi de cap. O companie poate comercializa acest model fără a mai trece prin filtrul juridic. Dacă dezvolți un produs de programare cu caracter comercial și ai nevoie de un backend de top pe care să-l poți găzdui legal pe propria infrastructură într-un mediu enterprise sigur, Qwen3-Coder-480B este cea mai sigură alegere.
Implementarea unui model cu 480 de miliarde de parametri necesită însă o infrastructură considerabilă. Chiar și cu o cuantizare pe 8 biți, este nevoie de aproape jumătate de terabyte de VRAM, ceea ce înseamnă un nod cu 8 plăci H100 sau MI300X. Cele 35 de miliarde de parametri activi per token mențin redusă latența de generare, însă capacitatea de memorie necesară pentru stocarea ponderilor dictează amprenta hardware.
MiniMax M3
MiniMax M3 se adresează fluxurilor de lucru complexe de front-end care necesită context vizual. Puteți introduce într-un prompt un export din Figma, un modul CSS și o captură de ecran cu un defect de interfață, cerându-i să adapteze aspectul flexbox după referința vizuală. Funcția multimodală nativă mapează direct designul vizual pe componentele React care necesită corecturi.
Are o fereastră de context de 1 milion de tokeni și obține un scor de 59% (raportat) la SWE-bench Pro. Funcționează în baza unei licențe personalizate, care restricționează utilizarea comercială. Cu un cost de aproximativ 0,30 USD per milion de tokeni pentru input și prețuri pentru output care variază în funcție de rutarea furnizorului API – situându-se de obicei între 0,96 USD și 2,40 USD –, este o alegere avantajoasă pentru sarcini multimodale.
Kimi K3
Modelul Kimi K3 de la Moonshot și-a publicat ponderile deschise pe 26 iulie 2026, ajungând la o anvergură de 2,8 trilioane de parametri. Acesta dispune de o fereastră de context de 1 milion de tokeni.
Acest model reprezintă capodopera de capabilități a ecosistemului open-source actual. Face față unor sarcini complexe de raționament algoritmic, programare de sisteme și optimizare a compilatoarelor. Având în vedere dimensiunea sa de 2,8T, este cel mai dificil de găzduit pe propria infrastructură, motiv pentru care rămâne accesibil aproape exclusiv prin API pentru majoritatea dezvoltatorilor.
Nivelul 2: Cele patru pe care le poți rula local
Pe 6 le închiriezi. Pe acestea 4 le deții.
Aici se vede avantajul open-source-ului pentru dezvoltatorii individuali. Fără facturi la API-uri. Fără cod proprietar care să părăsească dispozitivul tău. Nivelul de execuție este suficient de aproape de cel de vârf încât, în majoritatea activităților zilnice de programare, nici n-o să simți diferența.
Qwen3-Coder-Next
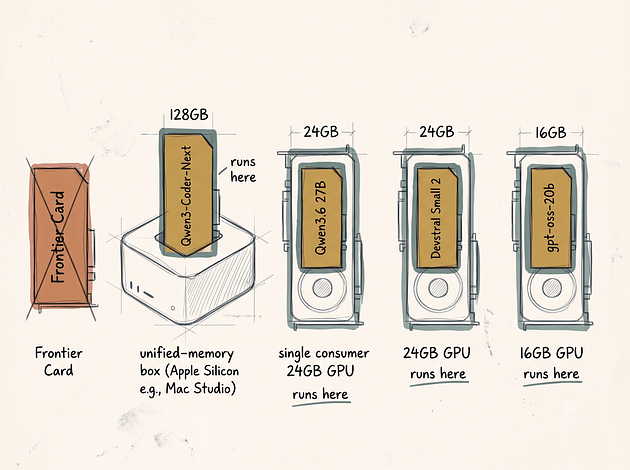
Dacă dețineți un Mac Studio de 64 GB sau 96 GB ori noul AMD Strix Halo de 128 GB, Qwen3-Coder-Next este modelul ideal pentru dumneavoastră. Este vorba despre un model cu un total de 80 de miliarde de parametri care obține un scor de 70,6% pe SWE-bench Verified și este disponibil sub licență Apache 2.0.
Datorită cuantizării pe 4 biți, rulează cu aproximativ 46 GB de memorie unificată. Adevărata realizare inginerească aici este arhitectura de tip amestec de experți (Mixture of Experts). Doar 3 miliarde de parametri se activează per token, ceea ce înseamnă că un model de programare de calitatea unuia cu 80 de miliarde de parametri rulează rapid pe un desktop performant, oferindu-ți viteze de raționament apropiate de cele ale modelelor de top, fără a bloca lățimea de bandă a memoriei.
Lățimea de bandă a memoriei este inamicul invizibil care ucide performanța modelelor locale de tip LLM. Atunci când generează un token, un model trebuie să citească ponderile active din memorie și să le transfere către nucleele de calcul. Un model dens cu 80 de miliarde de parametri presupune mutarea a 80 de miliarde de valori pentru fiecare cuvânt scris. Activând doar 3 miliarde de parametri, cerințele privind lățimea de bandă a memoriei scad considerabil, permițând obținerea a peste 50 de tokene pe secundă pe arhitecturile de memorie unificată pentru consumatori, cum este Strix Halo.
Qwen3.6 27B
Pentru dezvoltatorii independenți care folosesc o placă video de 24 GB, Qwen3.6 27B face față sarcinilor zilnice de programare fără să epuizeze memoria. Alibaba a lansat acest model dens în aprilie 2026 sub licența Apache 2.0. Necesită aproximativ 17 GB de VRAM la o precizie Q4, ceea ce înseamnă că rulează fără probleme pe o singură placă RTX 3090, 4090 sau 5090.
Este un model dens cu 27 de miliarde de parametri care ține pasul cu arhitecturi mult mai mari. Ollama îl rulează fără probleme pentru fluxurile de lucru standard de text și programare, folosind fișiere GGUF din comunitate. Dacă vrei să îi folosești capacitățile native deviziune multimodală, ai nevoie de fișierul separat mmproj, ceea ce presupune rularea prin llama.cpp sau LM Studio.
# Serving Qwen3.6 27B for coding (text-only) with llama.cpp
# -ngl 99 offloads all layers to the GPU for maximum speed
# -c 32768 sets the context budget to 32k tokens
./llama-server \
  -m models/Qwen3.6-27B-Q4_K_M.gguf \
  -c 32768 \
  -ngl 99 \
  --port 8080

# Note: Add --mmproj models/Qwen3.6-27B-mmproj-f16.gguf
# only if you specifically want to pass image inputs.
Devstral Small 2
Mistral a creat Devstral Small 2 special pentru sarcini care implică utilizarea de instrumente pe mai multe fișiere. Este un model dens cu 24 de miliarde de parametri, având o fereastră de context de 256.000 de tokeni. Rulează pe o placă video de 24 GB la precizie Q4 și este licențiat sub Apache 2.0.
Dacă integrați un model local într-un script Python care trebuie să execute comenzi shell, Devstral Small 2 respectă cu precizie constrângerile schemelor JSON și semnăturile funcțiilor. Este o alegere excelentă pentru framework-urile de tip agent atunci când aveți nevoie de o alternativă la arhitectura Qwen.
GPT-oss
OpenAI a lansat ponderi deschise sub familia gpt-oss. Modelul gpt-oss-20b are un total de 21 de miliarde de parametri, dintre care 3,6 miliarde sunt activi. Necesită aproximativ 14 GB de VRAM și încape pe o placă de 16 GB. Modelul mai mare, gpt-oss-120b, necesită hardware din clasa de 80 GB.
Astfel, tehnologia OpenAI devine disponibilă pe hardware-ul local. Modelul excelează în privința raționamentului înainte de a scrie efectiv codul. Acesta generează un șir intern de gândire, analizând logica unui algoritm complex înainte de a genera implementarea finală.
Cel pe care toată lumea îl înțelege greșit: autocompletarea
Toată lista de mai sus se concentrează pe modelele de tip chat și agenți. Niciunul nu este însă instrumentul potrivit pentru sarcina pe care o fac dezvoltatorii cel mai des. Completarea automată cu tasta Tab necesită o abordare complet diferită.
Autocompletarea se bazează pe completarea porțiunilor intermediare, cunoscută sub acronimul FIM (fill-in-the-middle). Acesta este un obiectiv specific de antrenament care învață modelul să anticipeze codul dintre liniile aflate deasupra și dedesubtul cursorului. Modelele lingvistice cauzale standard știu doar să prezică următorul cuvânt pe baza a ceea ce a fost înainte. FIM fragmentează fișierul în tokeni impărțiți în prefix, sufix și o secțiune mediană, antrenând modelul să facă legătura între acestea. Pentru o astfel de sarcină nu poți folosi un agent cu mii de miliarde de parametri; ai nevoie de un model mic și rapid, integrat direct în editor, care să genereze tokeni în milisecunde.
Codestral 2 este răspunsul open. Mistral l-a lansat în aprilie 2026 sub licență Apache 2.0, cu suport nativ pentru FIM. Are nevoie de 16–24 GB de VRAM pentru a rula.
Integrați acest lucru în Continue.dev, o extensie open-source pentru VS Code și JetBrains. Această configurație oferă funcția de completare a tab-ului similară cu Copilot, dar rulată local, cu o latență mai mică și fără abonament. Dacă aveți un hardware mai modest, alternativa este Qwen2.5-Coder 14B, care necesită aproximativ 9,5 GB de VRAM în format Q4.
Configurația necesită setarea rolului specific pe completare automată, astfel încât editorul să știe să formateze promptul folosind tokenii FIM corecți.
# ~/.continue/config.yaml
models:
– name: Codestral 2
provider: ollama
model: codestral:latest
roles:
– autocomplete
autocompleteOptions:
maxPromptTokens: 2048
debounceDelay: 250
Ce model pentru ce sarcină
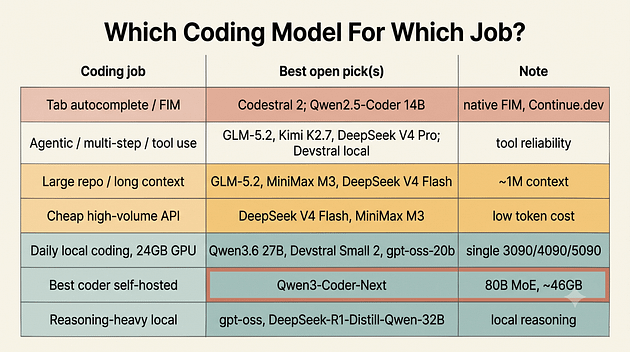
Un singur model este rareori potrivit pentru două sarcini diferite. Arhitectura trebuie adaptată fluxului de lucru, iar tabelul de mai jos detaliază cele mai bune opțiuni open-source, în funcție de cerințele specifice ale proiectului tău de programare.
Ce duce calculatorul tău
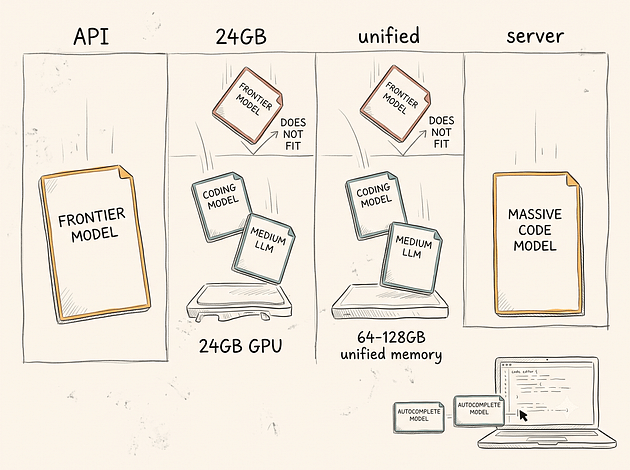
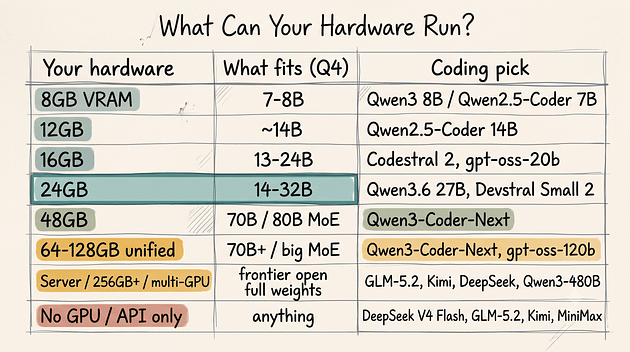
Regula generală pentru rularea locală este că, la o precizie Q4, ai nevoie de aproximativ 0,6 GB de VRAM pentru fiecare miliard de parametri. O placă de 24 GB poate găzdui un model de 32B, lăsând suficient spațiu și pentru o fereastră de context generoasă.
Arhitecturile cu memorie unificată funcționează altfel. Un Mac Studio cu 64 GB sau 96 GB de memorie ori un sistem AMD Strix Halo cu 128 GB poate rula modele care, în mod normal, ar necesita un server dedicat cu mai multe plăci video pentru enterprise.
Încheiere
Alegerea devine evidentă de îndată ce îți stabilești limitele hardware și fluxul de lucru. Caută-ți capacitatea de memorie în tabel, descarcă ponderile și integrează unealta potrivită direct în editorul tău.