Este gratuit, deschis și construit de oameni care au ajutat la crearea AlphaGo și Gemini. ChatGPT, Claude și Gemini sunt modele din America. Totuși, America nu a putut produce un model gratuit care să rămână în cursă.
Timp de aproape doi ani, oricine căuta cea mai bună IA pe care să o descarce și să o ruleze pe propriul hardware a ajuns la un model chinezesc. DeepSeek, Qwen, Kimi, GLM, MiniMax, MiMo de la Xiaomi. Se tot schimbau între ele, în timp ce laboratoarele americane își blocau cele mai puternice modele în spatele abonamentelor.
Doar în ultimul an, aproximativ 41% din tot ce s-a descărcat de pe Hugging Face a provenit de la modele chineze. Pe 5 octombrie, o companie din New York, deja cunoscută în anumite cercuri ca „DeepSeek-ul american”, a lansat în sfârșit un model care pare sa fie cel putin comparabil cu modelele chinezesti.
Modelul se numeşte Beam.
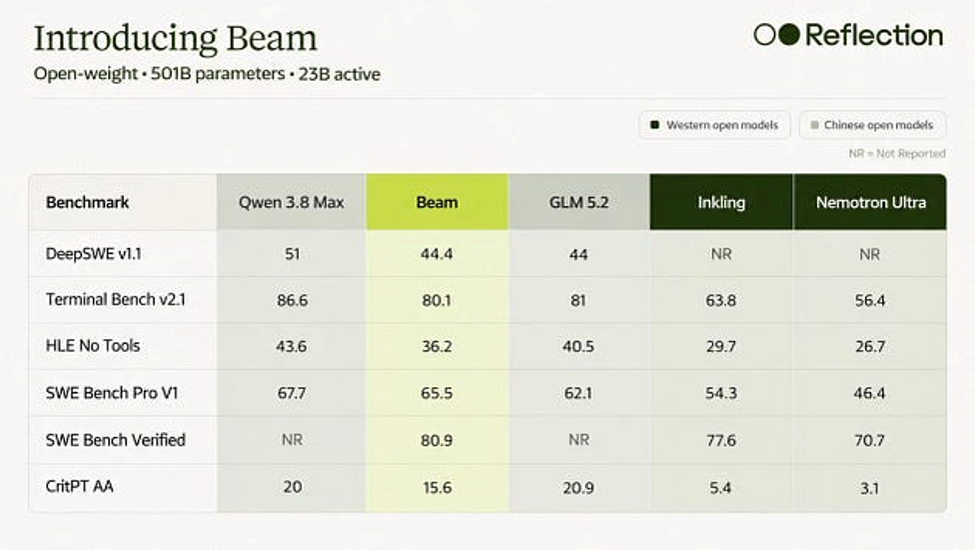
Nu e cel mai puternic model de pe piață dar asta nu contează prea mult.
De ce conteaza ?
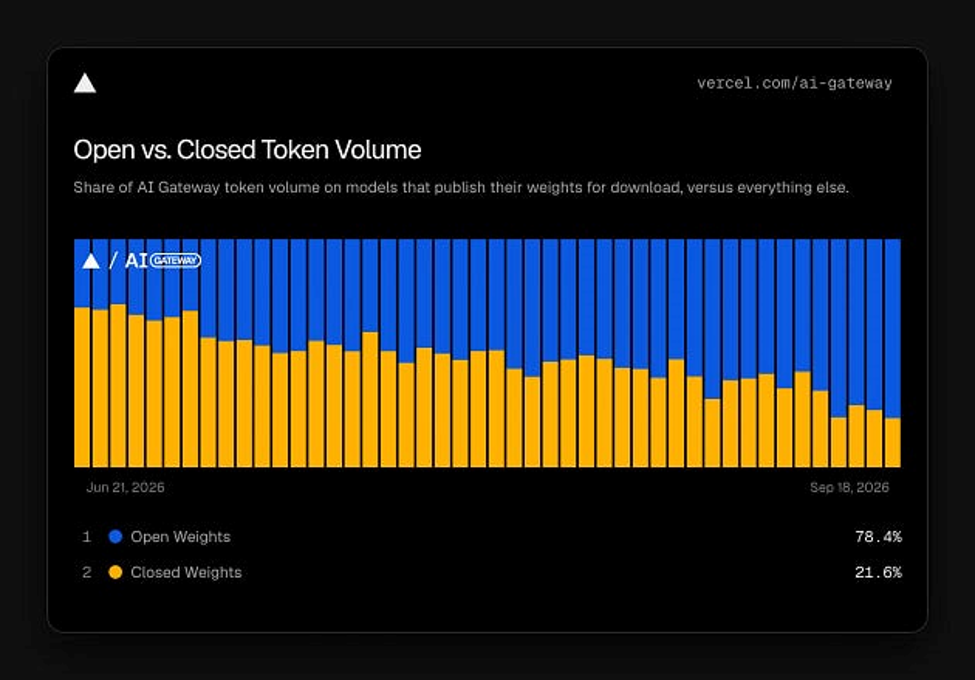
Volumul de jetoane deschise vs. închise al Vercel AI Gateway.
Modelele gratuite au încetat să mai fie o notă de subsol. Uitați-vă la AI Gateway de la Vercel. În decembrie, modelele deschise au reprezentat mai puțin de 10% din traficul său. Până în august, au reprezentat 56%.
Deci nu mai e vorba de bricolaj. Companiile pun sarcini reale pe modele gratuite. Chestia e că, în cea mai mare parte a timpului, primele alegeri au fost chinezești. Multe companii și guverne nu se pot apropia de ele, fie pentru că regulile interzic asta, fie pentru că pur și simplu nu vor. Dacă scrii cod, conduci o companie sau lucrezi undeva unde AI-ul chinezesc nu are acces, Beam este primul concurent american real pe care l-ai avut de mult timp.
Dacă nimic din cele de mai sus nu vă impresionează, tot există un motiv să fiți atenți. Modul în care Beam a fost antrenat ar putea deveni șablonul pentru modelele care vor urma.
Scurta prezentare
- Creator: Reflection AI, o companie din New York lansată în 2024
- Dimensiune: 501 miliarde de parametri în total, cu aproximativ 23 de miliarde care fac treaba pentru fiecare cuvânt
- Intrare: Numai text
- Puncte forte: Codare, raționament și agenți AI
- Date de instruire: 23,8 trilioane de token-uri de text și cod
- Fereastra de context: 1 milion de token-uri
- Setarea efortului: Dă-l mai încet pentru răspunsuri rapide, dă-l mai tare pentru sarcini mai grele
- Licență: Apache 2.0, adică o puteți folosi, modifica și vinde ce construiți cu ea, fără redevențe
- Stare: În testare finală cu o listă de așteptare pentru acces timpuriu; greutățile complete vor fi lansate luna aceasta
Oamenii din spatele ei…
Doi foști cercetători Google DeepMind au fondat Reflection.
Misha Laskin a lucrat la învățarea lui Gemini să facă diferența între un răspuns bun și unul rău.
Ioannis Antonoglou a fost în echipa AlphaGo, sistemul care a învins cei mai buni jucători umani de Go.
Amândoi și-au făcut un nume în învățarea prin întărire. (Învățarea unei IA lăsând-o să încerce, să eșueze și să fie recompensată când face lucrurile corect)
Dar construirea unui DeepSeek american nu a fost niciodată planul. Inițial, au vrut o IA care să poată scrie cod și să se ocupe de sarcini complicate de una singură, rulând pe orice modele deschise pe care le-au scos laboratoarele occidentale.
Dar apoi a apărut DeepSeek V3. Modelele chinezeşti au devenit tot mai bune. Iar Vestul nu avea nimic la acelaşi nivel pe care să se bazeze. Aşa că au schimbat direcţia cu un singur scop: să recâştige coroana open source pentru Vest.
Banii nu sunt o problemă. Nvidia și Sequoia îi susțin, compania a atins o evaluare de 25 de miliarde de dolari în iunie, iar acordurile cu SpaceX și Nebius au asigurat o cantitate uriașă de putere de calcul.
DeepSeek a devenit faimos pentru că a scos mult din puţin. Reflection scoate mult din mult.
7 lucruri care fac Beam diferit
1. Este imens, dar gândește ca un model de dimensiuni medii
501 miliarde de parametri e un număr mare. Dar e mai puțin impresionant și mai puțin semnificativ decât pare.
Beam folosește un design de „amestec de experți”. Un model obișnuit rulează fiecare parametru pentru fiecare cuvânt pe care îl produce. Amestecul de experți funcționează mai mult ca o recepție care înaintează fiecare apel departamentului potrivit. Fiecare cuvânt vizitează doar blocurile de specialiști de care are nevoie.
Daca-i dai lui Beam un script buggy Python, routerul indică acea sarcină specialiștilor săi de codare.
Deci ai o bibliotecă masivă de cunoștințe, dar fiecare cuvânt costă doar o cantitate modestă de calcul.
2. Fereastra de context de 1 milion de tokeni
O fereastră de un milion de token-uri vine cu propria durere de cap. Atenția standard verifică fiecare cuvânt nou față de fiecare cuvânt dinaintea lui, iar la acea dimensiune matematica pur și simplu nu mai funcționează.
Reflection a rezolvat asta alternând între două tipuri de straturi. Unul acordă atenție doar la ce e în apropiere, poate ultimele câteva sute de cuvinte. Celălalt se uită la un rezumat comprimat al întregului text. E ca și cum ai citi un roman, aruncând o privire din când în când la notițele tale. Nu recitești cartea la fiecare pagină, dar nici nu pierzi firul poveștii.
Memoria lungă a venit dintr-o etapă intermediară de antrenament plină cu depozite de coduri lungi, sarcini complicate și documente lungi de calitate.
3. A exersat de 100 de milioane de ori
Asta e partea care m-a uimit.
Primul pas a fost ceva standard. Cei 23,8 trilioane de tokeni ale lui Beam au trecut prin 6.144 de cipuri Nvidia GB300 în mai puțin de patru săptămâni.
Timp de încă patru săptămâni, 10.500 de cipuri GB300 au avut o singură treabă: să-l lase pe Beam să exerseze. În acea perioadă, au fost:
- Peste 100 de milioane de încercări la sarcini reale
- Aproximativ 1,3 miliarde de chipuri, care sunt mici computere unde IA poate rula cod fără a strica nimic
- Sarcini care acoperă știința, codificarea și munca de agent
- încercări unice care rulează până la 256.000 de jetoane
O încercare ar putea decurge astfel: Beam primește un obiectiv. Scrie un cod, îl rulează, apare o eroare, citește eroarea, îi vine o idee nouă, repară codul și încearcă din nou.
Acum imaginați-vă că se întâmplă de 100 de milioane de ori.
Ce m-a impresionat a fost că punctajele nu au încetat să crească după ce s-a terminat antrenamentul. În acest stadiu, majoritatea modelelor se plafonează și încep să păcălească sistemul de recompense în loc să învețe. Asta nu s-a întâmplat cu Beam.
4. A fost penalizat daca s-a rătăcit
Dintre toate detaliile din aceasta este cea care îmi place cel mai mult.
Beam primea recompense pentru finalizarea sarcinilor, dar pierdea puncte pentru că era prea lung. Fiecare frază inutilă sau pas de raționament irosea punctajul.
La început, răspunsurile sale s-au scurtat, în timp ce punctajele au crescut. Descoperea abordări mai inteligente, nu mai lungi. Mai târziu, pe măsură ce abilitățile agentului s-au îmbunătățit, răspunsurile s-au lungit din nou. Până atunci, lungimea suplimentară a plătit pentru rezultate reale.
E opusul a ceea ce face industria, care lasă modelele să gândească mai mult și presupune că mai multă gândire înseamnă gândire mai bună.
5. Profesorii lui s-au asigurat că nu poate trișa
Exersarea la această scară are un defect evident. Dacă sarcinile sunt prea ușoare, stricate sau pline de lacune, un miliard dintre ele îți oferă doar un miliard de lecții proaste.
Reflecția spune că asta s-a transformat într-un adevărat blocaj. Bazinele de sarcini slabe au făcut ca învățarea să se oprească devreme, iar echipa a trebuit să-și facă mediile mai dure și mai bune înainte ca Beam să înceapă să se îmbunătățească din nou.
Dă-i unui student un test uşor şi nu va mai învăţa.
Modelele AI sunt, de asemenea, foarte bune la depistarea bug-urilor în modul în care sunt notate, așa că Reflection a adus judecători separați pentru a verifica din nou fiecare răspuns care a trecut.
6. A rezolvat o problemă care dă peste cap majoritatea antrenamentelor AI
Rularea a 100 de milioane de încercări lungi creează o problemă de sincronizare. O încercare care rulează 256.000 de token-uri durează ceva timp, iar dacă întregul sistem ar aștepta la fiecare dintre ele, ar consuma o tonă de timp de cip.
Solutia Reflection a fost să facă totul deodată. Unele cipuri produceau încercări, iar alte cipuri actualizau modelul.
Efectul secundar are un nume: „stagnarea politicilor”.
Imaginați-vă un profesor care corectează prima jumătate a unui eseu în timp ce elevul încă scrie a doua jumătate. Până când vin comentariile, elevul a trecut deja mai departe. Cel care a scris introducerea nu e chiar aceeași persoană care scrie încheierea.
În mod normal, antrenarea unui model pe baza rezultatelor unei versiuni mult mai vechi a sa dă peste cap matematica. Trucul lui Reflection a fost să eticheteze fiecare token cu versiunea exactă a modelului care l-a creat, apoi să acorde token-urilor mai vechi o pondere mai mică în funcție de cât de depășite erau.
Site-ul Reflection descompune piesele care au făcut ca acest setup să funcționeze.
- Nimic nu așteaptă nimic. Agenții continuă să producă încercări, în timp ce antrenorul continuă să învețe și să scoată noi versiuni. Deoarece fiecare token poartă eticheta sa de versiune, antrenamentul se poate ajusta pentru învechire pe măsură ce încercările finalizate se revarsă.
- Cipul de divizare se mișcă odată cu munca. Pe măsură ce volumul de muncă s-a schimbat, Reflection a schimbat echilibrul între cipurile care rulează Beam și cipurile care îl antrenează, de la aproximativ 3,9 la 5,4 cipuri de rulare pentru fiecare cip de antrenament. Au redimensionat chiar și antrenorul de cinci ori diferite în timpul rulării fără a pierde progresul.
- Actualizările ajung rapid. Noile greutăți au ajuns la cipurile care rulează Beam în aproximativ 12 secunde (mediană). În loc ca fiecare copie să descarce greutățile pe cont propriu, acestea au fost transmise mai întâi între rafturi și apoi partajate local. Acest lucru a redus traficul între rafturi cu 75% și a răspândit noile greutăți de 2,2 ori mai rapid.
- Crash-urile nu au oprit antrenamentul. Lucrurile s-au stricat de 71 de ori în timpul rulării, iar antrenamentul nu s-a oprit niciodată. Capacitatea a revenit de obicei în aproximativ opt minute, iar timpul pierdut a reprezentat doar 0,02% din timpul total de servire.
- Sandbox-uri la scară masivă. Până la 170.000 de sandbox-uri au rulat în același timp. În toată platforma, au fost peste un miliard de cereri de creare a acestora, răspândite în peste 20 de clustere, două cloud-uri și patru regiuni. 90% au fost gata în mai puțin de 10 secunde.
- Aproape niciun spațiu irosit. Loturile de antrenament au rămas pline 99,99% în medie. Chiar și când încercarea tipică a devenit cu aproape 70% mai lungă, viteza per cip a scăzut cu cel mult 1,5%.
- Totul putea fi verificat de două ori. Fiecare jeton era înregistrat, astfel încât echipa putea confirma că antrenamentul și alergarea au rămas sincronizate la fiecare pas. Judecători independenți au reexaminat răspunsurile corecte pentru a depista înșelăciunile, iar înregistrările redate arătau exact cum au fost acordate și folosite recompensele.
Rezultatul a rezistat surprinzător de bine. Antrenamentul a rămas stabil pe date vechi de până la 107 versiuni, aproximativ o zi în urmă, cu aproximativ 110.000 de încercări care rulează în orice moment.
Pentru a-şi ţine toţi experţii la fel de ocupaţi, Reflection a împrumutat chiar o şmecherie direct de la DeepSeek.
Această muncă de culise ar putea fi cea mai importantă contribuție a proiectului. Sarcinile agentului sunt pur și simplu prea lungi pentru a fi antrenate în alt mod.
7. A învățat singur abilități pe care nimeni nu i le-a dat
O fază de antrenament s-a concentrat pe raționament, inginerie software și lucru la terminal. Nu a inclus nicio sarcină de navigare. Beam a devenit mai bun la navigarea pe web oricum.
Odată ce a avut acces la internet, a aflat singur cum să ceară ajutor altor modele de IA și cum să folosească instrumente care extrag text din documente și imagini. Nimeni nu i-a arătat cum.
Exemple de ce poate face Beam
Reflection a împărtășit cateva demo-uri:
- Un joc spațial 3D în care un astronaut se prăbușește spre Pământ, în timp ce doboară asteroizi
- O hartă live a metroului din New York cu trenuri care se mișcă în timp real, construită din date publice
- Antrenarea unui alt AI: Beam a reglat fin cel mai mic model Gemma 4 al Google pentru a transforma engleza simplă în interogări de baze de date, ridicându-i acuratețea cu 66,5%
Apoi a venit demo-ul despre care toată lumea vorbea.
Există un puzzle viral care cere unei IA să sorteze 16.200 de puncte de pe glob în uscat sau apă. Lucrând doar cu text, Beam a obținut 95,5% corect. Claude Opus 5 a obținut 92,5%. Doar Claude Fable 5, cu 97,8%, a terminat înaintea lui.
Un model pe care îl veți putea descărca în curând, depășind unul dintre modelele emblematice ale Anthropic într-un test urmărit de întregul internet. Nimeni nu se aștepta la asta de la un model american deschis anul acesta.
Cât de bun e Beam, de fapt? Depinde de testul la care te uiţi.
Unde se descurcă bine:
- 80.9 pe SWE-bench Verified, un benchmark de inginerie software dur
- 90,5 la GPQA Diamond, care testează știința la nivel de absolvent
Unde modelele chinezești cele mai noi sunt în față:
- Pe DeepSWE, unde agenții repară bug-uri reale în software real, Beam obține 44,4. Asta se potrivește cu GLM 5.2 din China din iunie, dar rămâne în urma DeepSeek V4.1 Flash (74,2), Kimi K3 (68) și GLM 5.3 (61)
- Pe Humanity’s Last Exam, Beam ia 36.2 iar Kimi K3 ia 46.9
- Pe SciCode, GLM 5.3 câștigă cu 59.0 la 49.7
- Qwen 3.8 Max iese în evidență pe LongBench și IFBench
Reflection însuşi admite că Kimi K3 este modelul mai puternic şi spune că Beam se apropie de Qwen 3.8 Max.
Pe scurt: Beam a ajuns din urmă ultima generaţie a Chinei şi se află cu o generaţie în urma celor mai noi.
Deci de ce să-ți pese dacă nu e cel mai bun?
Totul se reduce la eficienţă.
Conform Reflection, Beam ține pasul cu GLM 5.2 în raționamente dificile, folosind de trei-patru ori mai puțină putere de calcul. Lângă greii ca Qwen 3.8 Max, care are în jur de 2 trilioane de parametri, diferența devine și mai mare.
Ca să vă faceți o idee, Kimi K3 are 2,8 trilioane de parametri. Asta înseamnă de cinci ori și jumătate dimensiunea totală a lui Beam.
Laskin numește Beam un cal de povară, ceva ce companiile pot rula toată ziua fără să le epuizeze bugetul. Obținerea unor rezultate aproape de top cu mult mai puțină putere de calcul este exact ceea ce a transformat DeepSeek într-un nume cunoscut.
Numărul de eficiență este propria matematică a Reflection și acoperă doar o felie îngustă. Înmulțește doar parametrii activi cu jetoanele generate. Nu ia în calcul citirea promptului, costurile de atenție care cresc pe măsură ce crește contextul, amestecarea memoriei între cipuri și cheltuielile generale de servire a unui model.
Mai puțină putere de calcul nu garantează o factură mai mică. Dacă un server mută mereu 250 GB de greutăți, lățimea de bandă a memoriei poate mânca o mare parte din acele economii.
Îl poţi rula pe propriul tău calculator?
Pe scurt, nu.
A numi Beam un „model cu 23 de miliarde de parametri” dă o impresie greșită. Mixul de experți reduce calculul, dar nu reduce memoria în același mod. Nu poți încărca doar experții în codare și să-i lași pe ceilalți să stea pe hard disk, pentru că următorul cuvânt ar putea avea nevoie de un expert complet diferit. Toți cei 501 de miliarde de parametri trebuie să rămână în memorie.
Chiar și comprimat la 4 biți, doar greutățile necesită aproximativ 250,5 GB. Și asta înainte de a adăuga memoria cache KV (scratchpad-ul în care modelul ține evidența lucrului pe care l-a făcut deja pe promptul dvs.), bufferele de rutare și memoria de execuție. La contextul complet de un milion de token-uri, acel scratchpad devine uriaș.
Pentru a rula Beam corect sunt necesari mai mulți acceleratori care să lucreze în echipă. O placă video pentru jocuri nu este suficientă. Nici două.
Ca să fim corecți, e mult mai ușor decât Kimi K3. Punctul de control comprimat al lui Kimi e de aproximativ 1,4 TB, iar Moonshot recomandă 64 sau mai mulți acceleratori. Beam încă trăiește într-un centru de date, doar într-un colț mult mai mic al unuia.
Cum face bani un model gratuit?
Laskin rezumă totul cu o formulă: potențialul de venit egal cu densitatea inteligenței înmulțită cu scara de calcul înmulțită cu încrederea întreprinderii.
Modelul nu costă nimic, dar oricine îl rulează are nevoie de putere de calcul.
Reflection vrea să dețină întregul lanț de la modele până la propriile centre de date și se compară cu Amazon Web Services și Google Cloud în zilele lor de început.
Ideea e următoarea: timp de trei ani, companiile și-au închiriat AI-ul de la OpenAI, Anthropic și Google. Acum ar prefera să-l dețină.
Cel mai mare premiu sunt afacerile și guvernele care nu pot sau nu vor să atingă modelele chinezești. Această îngrijorare a crescut de când testerii guvernamentali din SUA și Marea Britanie au descoperit că modelele chinezești recente ar putea ajuta atacatorii să intre în software. Laskin spune că acești cumpărători pur și simplu nu au opțiuni bune astăzi.
Beam merită urmărit dacă:
- Lucrezi pentru o companie sau o agenție guvernamentală care nu are voie să folosească modele chineze.
- Construiți instrumente de codare sau agenți AI și doriți un model deschis care să fie complet sub controlul dvs.
- Te concentrezi mai mult pe costul per sarcină decât pe câștigarea fiecărui clasament
- Vrei o licență care să-ți permită să construiești și să vinzi liber
Beam probabil nu este pentru tine dacă:
- Ai nevoie de cel mai puternic model deschis disponibil acum (care este încă Kimi K3)
- Ai nevoie de un model care să poată înțelege imagini (Beam se ocupă doar de text)
- Speri să-l rulezi pe maşina ta.
Concluzia
Următorul model este deja în pregătire, iar Laskin spune că este un pas mare înainte. Chiar mai mari sunt pe foaia de parcurs pentru 2027. Antonoglou spune că nu există nicio regulă tehnică care să forțeze modelele deschise să rămână în urma celor închise.
În acest moment, Beam nu ne spune cât va costa cu adevărat sau cât de rapid va funcționa. De asemenea, nu dovedește că rețeta sa de antrenament este calea potrivită pentru toată lumea.