Răspuns rapid: Modelul publicat de comunitate JonathanColetti/Qwen3.8–27B-Uncensored-GGUF reprezintă o cuantizare GGUF a unei versiuni abliterate (cu refuzuri reduse) a versiunii oficiale Qwen3.8–27B. Modelul de bază este un model vizual-lingvistic dens, cu 27 de miliarde de parametri, o fereastră de context nativă de 262.144 de tokeni, suport pentru utilizarea uneltelor și licență Apache 2.0. Puteți descărca o cuantizare GGUF de pe Hugging Face, o puteți încărca în LM Studio ori Ollama pe orice Mac cu Apple Silicon care dispune de suficientă memorie unificată și puteți adăuga pluginul Valyu pentru LM Studio pentru căutări web în timp real.
Care este identitatea exactă a modelului?
Repositoriul este sursa principală pentru fișierele GGUF pe care le veți rula în LM Studio. Ambele au fost publicate în comunitate de JonathanColetti. JonathanColetti/Qwen3.8–27B-Uncensored-GGUF pe Hugging Face
Punctul de control de bază este Qwen/Qwen3.8–27B, publicat de echipa Qwen a Alibaba pe Hugging Face. Conform fișei oficiale a modelului, Qwen3.8–27B este un model post-antrenat în formatul Hugging Face Transformers, compatibil cu vLLM, SGLang și motoare de inferență similare.
Echipa Qwen menționează, de asemenea, că orice versiune găzduită Qwen Cloud va oferi o lungime de context de 1 milion de jetoane și instrumente integrate, deși serviciul respectiv este separat de lansarea modelelor open-weight.
Modificarea „necenzurată” a fost realizată folosind metoda Heretic, care minimizează simultan numărul de refuzuri în raport cu divergența KL față de modelul de bază, fără nicio ajustare fină suplimentară sau date de antrenament adiționale. Potrivit versiunii lui JonathanColetti, rata de refuz pe un set de test de 100 de prompturi cu conținut dăunător a scăzut de la 98/100 la 12/100, ceea ce reprezintă o reducere de 88%. Fișa modelului precizează în mod explicit că comportamentul de refuz a fost „redus semnificativ, nu eliminat”.
Ce înseamnă în practică numărul de parametri și eticheta „necenzurat”?
Qwen3.8–27B este un model dens cu 27 de miliarde de parametri, nu o arhitectură bazată pe un amestec de experți. Fiecare parametru este activ pentru fiecare token, ceea ce înseamnă că amprenta completă a modelului trebuie să încapă în memorie în momentul inferenței. Acest lucru este confirmat atât de fișa oficială a modelului Qwen de pe Hugging Face, cât și de pagina modelului LM Studio pentru Qwen3.8.
Pagina modelului LM Studio pentru Qwen3.8–27B îl descrie drept „un model vizual-lingvistic dens cu 27 de miliarde de parametri pentru programare, activități profesionale, cercetare și sarcini complexe de tip agent pe termen lung, beneficiind de un raționament configurabil și de o fereastră de context nativă de 262K tokeni”. Capacitățile confirmate din sursele primare includ:
- Intrare vizuală: Modelul acceptă text, imagini și fișiere video ca date de intrare. Atât pagina modelului LM Studio, cât și descrierea oficială de pe Hugging Face confirmă suportul multimodal.
- Fereastra de context: 262.144 de tokeni (262K), nativ. Echipa Qwen menționează că versiunea găzduită Qwen Cloud va extinde această limită la 1 milion de tokeni, însă versiunea open-weight păstrează limita de 262K.
- Utilizarea instrumentelor: Pagina modelului de pe LM Studio confirmă suportul pentru utilizarea instrumentelor. De asemenea, depozitul GGUF de la unsloth menționează îmbunătățiri în apelarea instrumentelor pentru parsarea obiectelor imbricate.
- Raționament configurabil: modelul acceptă un mod de gândire care poate fi activat și dezactivat, după cum se confirmă pe pagina modelului din LM Studio și în repository-ul unsloth.
Eticheta „necenzurat” înseamnă în mod specific că tendința modelului de a refuza solicitările dăunătoare a fost redusă prin metoda de abliterare Heretic. Asta nu înseamnă că modelul este lipsit de prejudecăți, corect din punct de vedere factual, sigur în orice scenariu sau scutit de moderarea la nivel de sistem din partea sistemului de operare, a aplicației ori a platformei pe care îl rulați.
Fișa de model JonathanColetti este explicită: capacitățile, datele de antrenament și arhitectura rămân altfel neschimbate față de modelul de bază. Modificarea vizează doar direcția refuzului în spațiul de activare.
Ce cuantificări GGUF funcționează cu LM Studio și de câtă memorie ai nevoie?
LM Studio rulează pe Mac-urile cu Apple Silicon (M1/M2/M3/M4) având macOS 14.0 sau o versiune ulterioară. Pagina oficială cu cerințele de sistem pentru LM Studio recomandă cel puțin 16 GB de RAM și menționează că Mac-urile cu 8 GB pot rula modele mai mici, cu dimensiuni moderate ale contextului. Mac-urile cu procesoare Intel nu sunt acceptate.
Pagina modelului LM Studio pentru Qwen3.8–27B indică o dimensiune de descărcare de 16,10 GB pentru cea mai mică cuantizare disponibilă și precizează că 16 GB de memorie RAM reprezintă minimum necesar pentru rularea acestuia. Acesta este un detaliu esențial: un Mac cu 16 GB poate încărca teoretic cea mai mică cuantizare, dar lasă foarte puțin spațiu pentru context, sistemul de operare și alte aplicații. Cuantizările mai mari (Q5, Q6, Q8) generează fișiere mai mari și necesită o cantitate corespunzătoare de memorie.
Dimensiunile fișierelor pentru fiecare nivel de cuantificare trebuie verificate în lista de fișiere de pe Hugging Face înainte de descărcare. Nivelul Q4_K_M reprezintă o alegere frecventă pentru utilizarea locală și un punct de plecare rezonabil dacă Mac-ul dvs. dispune de suficientă memorie unificată pentru a-l găzdui.
Cum să descarci, încarci, configurezi și testezi modelul în LM Studio
Pasul 1: Instalează LM Studio
Descărcați LM Studio de pe site-ul oficial. Aplicația rulează pe Mac-uri cu Apple Silicon și macOS 14.0 sau o versiune ulterioară. Deschideți aplicația și verificați setările pentru a găsi opțiunile de accelerare GPU, care pot ajuta modelul să utilizeze memoria unificată mai eficient.
Pasul 2: Descărcați fișierul GGUF
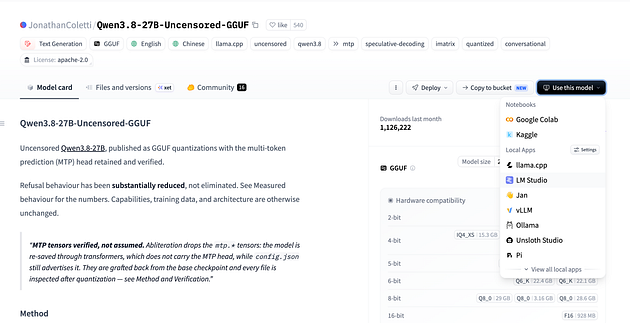
Accesați repo-ul GGUF de pe Hugging Face. Navigați în secțiunea „Files” și selectați un singur fișier GGUF care să corespundă memoriei Mac-ului dvs. Alegeți o cuantizare care să se încadreze confortabil în memoria unificată disponibilă, lăsând spațiu pentru cache-ul KV și sistemul de operare.
Puteți descărca fișierul direct prin intermediul browserului de modele integrat în LM Studio.
Apăsați Enter sau faceți clic pentru a vizualiza imaginea la dimensiunea completă
Pasul 3: Încărcarea modelului
Odată ce descărcarea se încheie, accesați fila Chat din LM Studio. Selectați modelul descărcat din meniul de selecție a modelelor din partea superioară. LM Studio va încărca modelul în memoria unificată. Urmăriți bara de încărcare; dacă modelul nu reușește să se încarce sau sistemul începe să folosească memoria virtuală de pe disc (indicat de activitatea susținută a discului și de generarea foarte lentă a tokenilor), înseamnă că gradul de cuantizare este prea mare pentru memoria disponibilă. Treceți la o cuantizare mai mică și încercați din nou.
Notă: În experiența mea cu mai multe versiuni ale modelelor Qwen abliterate pe un MacBook M5 cu 16 GB de RAM, obții o experiență rapidă, plăcută și deloc frustrantă doar atunci când folosești modelul Qwen 3.5–9B abliterated Q4_K_M GGUF. Este foarte important să știi acest lucru. Modelul Qwen 3.8 27B se va încărca și va funcționa totuși, dar este atât de lent încât devine aproape inutilizabil, deoarece blochează toată memoria și poate duce la blocarea constantă a MacBook-ului. Pentru un MacBook M5 cu 64 GB de RAM, acest lucru nu va fi nicio problemă!
Pasul 4: Configurați contextul și descărcarea pe GPU
Două setări contează cel mai mult pentru un model de 27B pe un Mac:
- Descărcare pe GPU: Setați această opțiune la numărul maxim de straturi. Pe Apple Silicon, backend-ul Metal gestionează automat descărcarea pe GPU. LM Studio ar trebui să descarce toate straturile pe GPU în mod implicit. Dacă acest lucru nu se întâmplă, setați manual cursorul de descărcare la valoarea maximă.
- Lungimea contextului: modelul suportă nativ 262.144 de tokeni, însă nu este recomandat să setați contextul la valoarea maximă pe un Mac cu resurse limitate de memorie. Cache-ul KV pentru contexte lungi consumă o cantitate semnificativă de memorie unificată. Începeți cu o lungime moderată a contextului și măriți-o doar dacă aveți suficientă memorie disponibilă și scenariul de utilizare o cere.
Pasul 5: Testarea modelului
Începeți cu un prompt simplu pentru a confirma că modelul generează text. Apoi testați cu un prompt pe care un model aliniat pentru siguranță l-ar refuza în mod obișnuit, de exemplu, o solicitare privind un exploit de securitate fictiv sau un subiect sensibil din punct de vedere politic. Modelul ar trebui să răspundă acolo unde modelul de bază Qwen3.8–27B ar refuza, însă calitatea răspunsului depinde de cuantificare și de promptul specific.
Verificați dacă funcționează introducerea de conținut vizual atașând o imagine la mesajul dumneavoastră și rugând modelul să o descrie. Arhitectura Qwen3.8–27B acceptă imagini și videoclipuri ca date de intrare. Pagina dedicată orcarouter de pe Ollama confirmă compatibilitatea completă cu funcția „mmproj vision” pentru varianta lor a aceluiași model lipsit de cenzură.
Testați apelul de funcții activând formatul de utilizare a instrumentelor în LM Studio și furnizând o definiție simplă a unei funcții. Depozitul unsloth Qwen3.8–27B menționează îmbunătățiri ale apelului de funcții pentru parsarea obiectelor imbricate, ceea ce sugerează că arhitectura este concepută pentru fluxuri de lucru bazate pe agenți.
Alte trei modalități de a rula modelul Qwen necenzurat
Alte trei modalități de a rula modelul Qwen necenzurat
Dacă Mac-ul tău nu dispune de suficientă memorie unificată pentru un model dens de 27B sau dacă preferi un alt stil de implementare, ai la dispoziție trei alternative care acoperă întregul spectru, de la interfața locală în linie de comandă până la un API găzduit.
Opțiunea 1: Ollama pentru o interfață locală în linie de comandă mai simplă
Ollama este un motor de inferență în linie de comandă pentru rularea modelelor GGUF. Pagina orcarouter/Qwen3.8–27B-Uncensored de pe Ollama prezintă modelul cu eticheta de cuantizare Q4_K_M și raportează 16.900 de descărcări. Pagina Ollama confirmă suportul complet pentru viziune mmproj, apelarea de funcții, modul de gândire și un context de 262K pentru varianta abliterată.
Pentru a-l rula:
ollama run orcarouter/Qwen3.8-27B-Uncensored
Ollama poate ajuta la alegerea cuantificării și la gestionarea memoriei. Se aplică aceleași restricții privind memoria unificată: ponderile modelului și memoria cache KV trebuie să încapă în continuare în memoria RAM a Mac-ului tău.
Ollama nu oferă în mod implicit o interfață grafică de chat, dar pune la dispoziție un API local pe care alte instrumente și scripturi îl pot apela. Dacă folosiți deja LM Studio, Ollama acoperă aceleași cerințe hardware, dar cu un consum mai redus de resurse și fără suprasolicitarea unei interfețe grafice.
Opțiunea 2: Server GPU Hetzner Cloud pentru inferență de la distanță
Dacă echipamentul local nu poate suporta un model 27B, puteți închiria un server în cloud dotat cu GPU și să rulați modelul acolo.
Hetzner Cloud oferă servere GPU potrivite pentru inferența modelelor lingvistice mari (LLM). Conform unui ghid de configurare din 2026, oferta Hetzner de servere GPU variază de la instanțe economice bazate exclusiv pe CPU până la servere dedicate cu GPU RTX 4000 Ada, la aproximativ 184 € pe lună, prețurile valabile după luna iunie 2026 fiind documentate în ghid.
Această abordare mută integral sarcina de inferență de pe Mac-ul tău. Solicitările și răspunsurile modelului circulă prin tunelul tău SSH până la GPU-ul la distanță și înapoi. Modelul în sine rulează în memoria VRAM a serverului, așa că memoria unificată a Mac-ului tău nu constituie o constrângere. Tu ești responsabil de configurarea securității serverului, de regulile firewall-ului și de gestionarea costurilor.
Poți rula numeroase modele .open direct de pe pagina lor de experimente.
Opțiunea 3: Featherless pentru un API găzduit fără infrastructură
De asemenea, oferă o interfață API compatibilă cu formatul OpenAI pentru completările de chat, astfel încât puteți direcționa clienții compatibili către punctul final Featherless. Aceasta include scripturi Python, asistenți de programare și cadre de lucru pentru agenți care acceptă o adresă URL de bază personalizată. Nu aveți control asupra cuantificării, a limitei ferestrei de context sau a hardware-ului utilizat; acestea sunt stabilite de furnizorul de Găzduire.
Compromisul îl reprezintă confidențialitatea și controlul. Fiecare prompt pe care îl trimiteți către un API găzduit părăsește dispozitivul dumneavoastră și este procesat pe o infrastructură care nu vă aparține. Pentru cercetare și experimentare, acest lucru poate fi acceptabil. În schimb, pentru sarcini de lucru sensibile sau confidențiale, inferența locală pe un Mac sau pe un server gestionat în regie proprie, cum este opțiunea Hetzner, vă oferă o barieră de confidențialitate mult mai solidă.
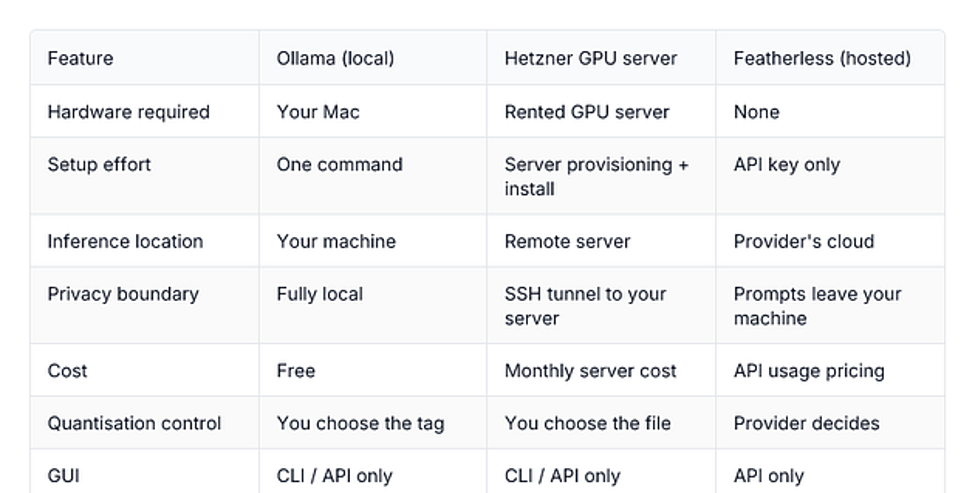
Compararea celor trei alternative
Ce scenarii de utilizare face posibile modelul și ce limitări îi mai rămân?
- Cercetare și experimentare: Comportamentul redus de refuz le permite cercetătorilor să studieze comportamentul modelelor în cazul prompturilor pe care modelele aliniate le resping. Tehnica de abliterare însăși face obiectul unor studii academice în curs, existând articole pe arXiv care analizează atât metoda, cât și măsurile de protecție împotriva acesteia.
- Asistență la programare: Qwen3.8–27B este conceput pentru sarcini de programare, iar versiunea necenzurată își păstrează această capabilitate. Fișa modelului menționează că arhitectura și datele de antrenament rămân neschimbate față de modelul de bază.
- Redactarea și generarea de texte extinse: Cu o fereastră de context de 262.000 de tokeni, modelul poate procesa documente lungi. Acest lucru este util pentru sintetizarea unor articole ample, redactarea de secțiuni pentru documente tehnice sau generarea de rezultate structurate.
- Analiza datelor locale: Deoarece inferența rulează pe Mac-ul tău, poți introduce documente confidențiale în model fără să le trimiți către un API în cloud. Procesul rămâne pe dispozitivul tău, cu excepția cazului în care adăugați un pas de preluare extern.
Limite de înțeles
- Halucinație: Reducerea comportamentului de refuz nu îmbunătățește acuratețea factuală. Modelul va genera în continuare informații incorecte și s-ar putea să o facă fără rețineri pe subiecte în legătură cu care un model aliniat ar refuza să răspundă sau ar adopta o poziție rezervată. Fiecare afirmație cu caracter factual a modelului necesită verificare umană.
- Siguranță: Abliteration elimină un mecanism de siguranță. Modelul poate genera rezultate dăunătoare, înșelătoare sau inadecvate pentru context. Acesta este un instrument de cercetare, nu un asistent pentru mediu de producție. Blogul orcarouter își etichetează varianta ca „DOAR PENTRU CERCETARE”, iar același principiu se aplică și versiunii JonathanColetti.
- Domenii cu risc ridicat: În cazurile de utilizare medicală, juridică, financiară sau de securitate cibernetică, reducerea comportamentului de refuz nu înlocuiește raționamentul profesional, măsurile de securitate sau evaluarea umană.
- Licențiere: Apache 2.0 permite utilizarea comercială, însă sunteți responsabil pentru conformitate. Licența include termeni și condiții specifice pe care ar trebui să le citiți integral în fișa modelului. Disponibilitatea deschisă nu conferă automat toate drepturile comerciale fără obligații.
- Limită de confidențialitate: Inferența locală vă păstrează prompturile și răspunsurile modelului pe computer. Dacă adăugați un modul de căutare pe web, acele interogări părăsesc Mac-ul și sunt trimise către un API extern. Inferența locală în sine rămâne privată, însă pasul de regăsire, nu.
Cum se adaugă căutarea și recuperarea web
LM Studio acceptă pluginuri care extind modelele locale cu unelte externe. Pluginul Valyu este disponibil pe Hub-ul LM Studio. Acesta le permite modelelor LLM locale din LM Studio să caute pe web și să preia conținutul paginilor web în timp real.
- Instalează pluginul. Apasă pe „Adaugă la LM Studio” pentru a-l instala direct.
- Obțineți o cheie API de la platform.valyu.ai. Conturile noi primesc credite gratuite în valoare de 10 dolari, fără a fi nevoie de un card de credit.
- Adăugați cheia API în setările pluginului din LM Studio. Deschideți configurația pluginului, introduceți cheia și salvați.
Odată configurat, pluginul îi oferă modelului tău local capacitatea de a utiliza un instrument de căutare web în timpul unei conversații. Atunci când modelul stabilește că are nevoie de informații actualizate, trimite o interogare de căutare către API-ul Valyu, care returnează conținut web pe care modelul îl poate integra în propriul răspuns.
Ce schimbă și ce nu schimbă acest lucru
Acesta oferă modelului acces la informații actuale de pe internet. Pasul de căutare pe web este un instrument, nu o garanție a fundamentării factuale.
Indexul Valyu acoperă literatura academică, cercetările peer-reviewed, documentele normative, standardele tehnice, fișierele PDF, sursele specializate și întregul internet. Acest lucru înseamnă că o interogare de căutare poate extrage informații din documente primare, în loc să se bazeze pe rezumate de la terți, ceea ce este util pentru fluxurile de lucru din cercetare unde proveniența sursei contează.
Întrebări frecvente
Nu. Punctul de control de bază Qwen/Qwen3.8–27B este o lansare oficială a echipei Qwen pe Hugging Face sub licența Apache 2.0. Depozitul JonathanColetti/Qwen3.8–27B-Uncensored-GGUF este o modificare a unui terț care aplică metoda de abliterare Heretic pentru a reduce comportamentul de refuz, după care convertește rezultatul în format GGUF. Fișa modelului delimitează în mod explicit versiunea necenzurată de punctul de control oficial.
Abliteration este o tehnică de post-antrenament care identifică „direcția de refuz” în spațiul de activare al unui model, adică vectorul care diferențiază răspunsurile la prompturile dăunătoare de cele la prompturile inofensive, și îl atenuează. Acest lucru reduce tendința modelului de a refuza solicitările fără a fi necesare o ajustare fină suplimentară sau date de antrenament noi. Versiunea realizată de JonathanColetti a redus numărul de refuzuri de la 98/100 la 12/100 pe un set de rezervă format din 100 de prompturi dăunătoare. Fișa modelului menționează că comportamentul de refuz este „redus în mod substanțial, nu eliminat”.
Un Mac cu Apple Silicon și 16 GB de memorie poate încărca cea mai mică cuantizare GGUF disponibilă (aproximativ 16 GB dimensiune de descărcare, așa cum este specificat pe pagina modelului din LM Studio), dar acest lucru lasă un spațiu extrem de restrâns pentru cache-ul KV, sistemul de operare și alte aplicații. Lungimea contextului va fi sever limitată. Un Mac cu mai multă memorie unificată oferă o experiență mai practică pentru utilizarea cuantizării Q4_K_M. Verificați dimensiunea exactă a fișierului în depozitul Hugging Face înainte de descărcare.
Trei alternative acoperă diferite stiluri de implementare. Ollama rulează local același model ablaționat, prin linia de comandă, pe Apple Silicon. Hetzner Cloud îți permite să închiriezi un server cu GPU și să rulezi modelul la distanță, mutând astfel sarcina de memorie de pe Mac-ul tău. Featherless găzduiește versiunea Qwen Uncensored sub formă de punct final API, eliminând necesitatea oricărui hardware local sau a descărcărilor, deși mesajele tale părăsesc dispozitivul. Fiecare opțiune implică un compromis diferit între comoditate, cost și confidențialitate.
Nu. Reducerea comportamentului de refuz înseamnă că modelul va răspunde la mai multe solicitări, însă acuratețea sa factuală rămâne neschimbată față de modelul de bază. Modelul va continua să halucineze. Pentru orice afirmație bazată pe fapte, în special în contexte medicale, juridice, financiare sau de securitate, trebuie să verificați rezultatul în mod independent.
Licența Apache 2.0 permite utilizarea comercială, modificarea și distribuirea. Cu toate acestea, aveți responsabilitatea de a citi și de a respecta integral textul licenței menționat în fișa modelului. Disponibilitatea liberă a ponderilor modelului nu conferă automat toate drepturile comerciale fără nicio obligație. Dacă intenționați să implementați modelul într-un produs comercial, consultați termenii licenței și orice restricții moștenite de la punctele de control de bază Qwen3.8–27B.